
Algoritmos de ML para reconocer el alfabeto estático de la lengua de señas peruana
Preprint: manuscript without confirmed peer review.
This paper is currently available in Spanish. Read the original ↗
Abstract
Comparación de seis clasificadores en CPU con 2500 registros angulares: Extra Trees obtiene el mejor resultado observado, con 97,80 % de exactitud.
Entrenar y comparar algoritmos para reconocer señas estáticas
Este estudio compara seis algoritmos de aprendizaje automático con una misma representación geométrica de la mano. La pregunta es qué clasificador obtiene el mejor desempeño observado en el reconocimiento del alfabeto dactilológico estático de la lengua de señas peruana.
Se entrenaron árbol de decisión, Extra Trees, KNN, regresión logística, Random Forest y SVM radial. La comparación se ejecutó en CPU, sin contratar GPU. Kaggle se utilizó para descargar el dataset; no se ejecutaron kernels de entrenamiento en esa plataforma.
El artículo está disponible en español, con la identidad editorial de CREH Labs. Se publica como preprint: no se atribuye revisión por pares ni publicación en arXiv.
Cómo se obtuvieron las imágenes y las características
La captura comienza al encender la cámara y asignar una letra a la postura de la mano. MediaPipe detecta 21 puntos de la muñeca y los dedos. Sus coordenadas mínimas y máximas forman un rectángulo que delimita la mano.
La rutina histórica recuperada toma el mayor lado de ese rectángulo como referencia. Construye un recorte anclado en sus coordenadas mínimas, con un margen del 25 % del lado de referencia y una extensión aproximada de 1,5 veces ese lado en ambas direcciones. Los límites se ajustan para permanecer dentro del cuadro.
Solo se aceptan recortes cuyo ancho y alto superen 224 píxeles. Se redimensionan a 224 × 224 píxeles, se guardan con su etiqueta y se intenta reunir 100 imágenes por letra. Así se obtiene una colección de posturas manuales con resolución común. Si el recorte llega al borde del cuadro, puede perder su proporción cuadrada antes del redimensionamiento.
Las imágenes contienen la apariencia de la mano; los 21 puntos describen su estructura. A partir de ellos se calculan 15 ángulos articulares y una orientación desde la muñeca hacia la base del dedo medio. Cada ejemplo de entrenamiento reúne esas 16 medidas y la etiqueta correspondiente. Los clasificadores aprenden de esta geometría, sin recibir directamente todos los píxeles de la imagen.
El conjunto evaluado contiene 2500 registros y 25 clases balanceadas, con 100 registros por clase: 24 letras y espacio. No se encontraron valores no finitos ni duplicados exactos. La tabla no incluye identidades de participantes o sesiones. La comparación comienza con las características disponibles: no se hizo una nueva captura ni se verificó una correspondencia individual entre las imágenes históricas y los registros evaluados.
Consultar el código original de captura. Es un extracto del notebook histórico, conservado como evidencia del procedimiento.
Qué aprende cada algoritmo
Todos reciben las mismas 16 características y predicen una de las 25 clases:
- Árbol de decisión: divide los ejemplos mediante preguntas sobre sus ángulos y orientación. Cada división busca reducir la mezcla de clases, hasta llegar a una hoja que determina la predicción.
- Extra Trees: combina 100 árboles con atributos y umbrales de corte aleatorios. Agrega sus predicciones para reducir la dependencia de una única estructura de decisión.
- KNN: compara una postura con los cinco ejemplos más cercanos y decide por sus etiquetas. Las características se estandarizan para que su escala no domine la distancia.
- Regresión logística: aprende una puntuación lineal por clase y la transforma en probabilidades relativas. Utiliza regularización y características estandarizadas.
- Random Forest: combina 100 árboles entrenados con muestras de los datos tomadas con reemplazo. En cada división considera un subconjunto aleatorio de características y busca el corte que mejor separa las clases.
- SVM radial: aprende fronteras que separan las clases mediante un kernel basado en la similitud entre posturas. Puede representar relaciones no lineales y utiliza características estandarizadas.
Protocolo experimental
Se reservó el 20 % de los registros para prueba: 500 ejemplos, 20 por clase. Los 2000 restantes se utilizaron para entrenamiento y validación cruzada estratificada de cinco particiones, con semilla 42. No se realizó búsqueda de hiperparámetros sobre la prueba.
KNN, SVM y regresión logística incluyen estandarización, ajustada dentro de cada pipeline y partición de entrenamiento. Los árboles usan los atributos sin escalado. Extra Trees y Random Forest emplean 100 árboles.
Se realizó también una prueba de sensibilidad al orden: primeras 80 filas de cada clase para entrenar y últimas 20 para probar. Esta separación no equivale a dejar fuera personas o sesiones, porque el dataset no contiene esos identificadores.
Resultados medidos
| Algoritmo | Exactitud | F1 macro | MCC |
|---|---|---|---|
| Árbol de decisión | 93,40 % | 93,36 % | 0,9314 |
| Extra Trees | 97,80 % | 97,78 % | 0,9772 |
| KNN | 96,20 % | 96,17 % | 0,9605 |
| Regresión logística | 96,60 % | 96,53 % | 0,9649 |
| Random Forest | 96,80 % | 96,70 % | 0,9668 |
| SVM radial | 96,80 % | 96,79 % | 0,9668 |
Estas métricas corresponden a los 500 registros reservados, con modelos ajustados en las otras 2000 filas. No representan confianza instantánea de la aplicación ni una prueba con 500 personas.
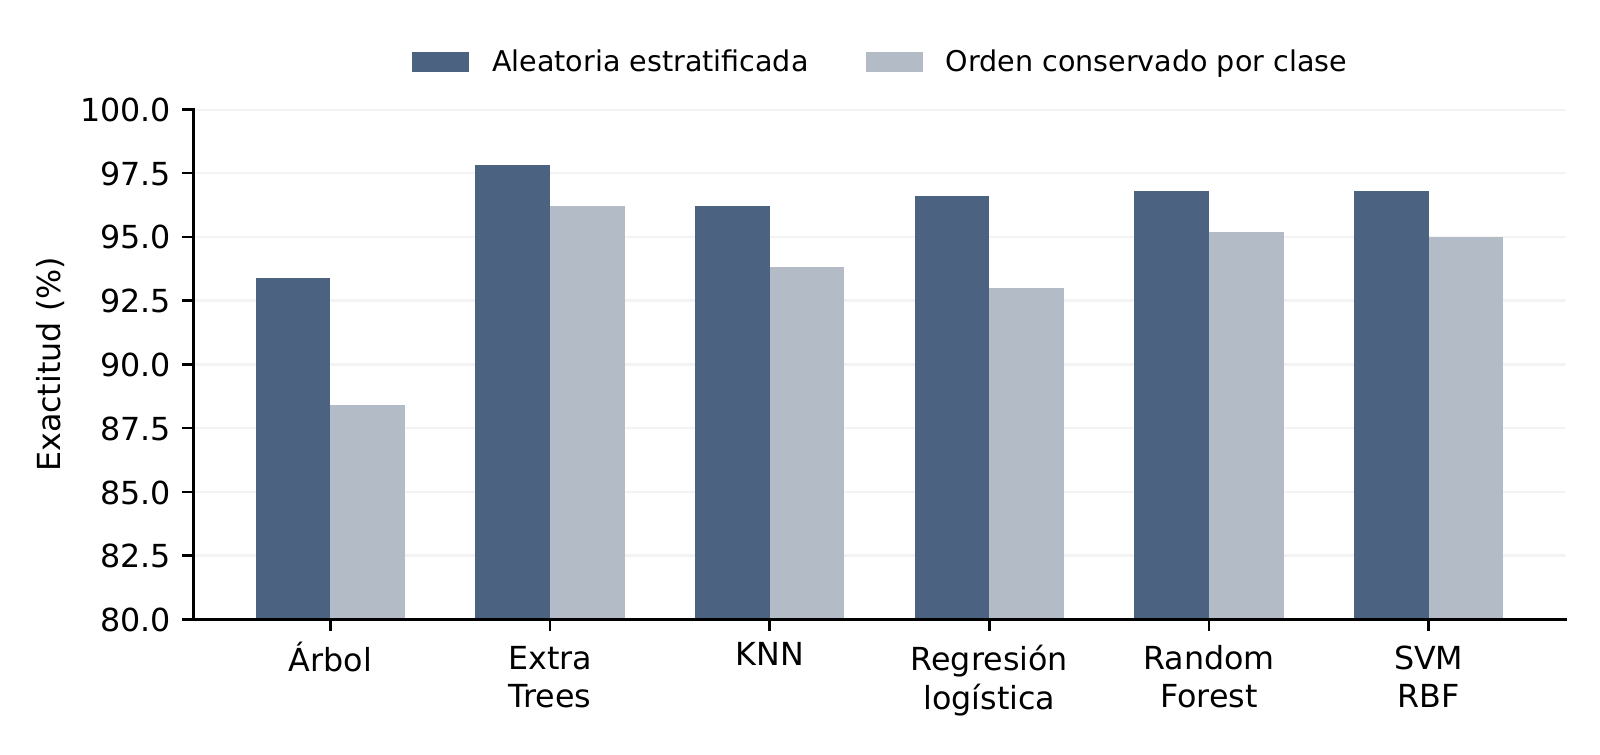
Figura de elaboración propia a partir de los resultados ejecutados. Ambos protocolos tienen 500 registros de prueba.
Extra Trees acertó 489 de 500 registros. Su exactitud media en validación cruzada fue 97,65 % y alcanzó 96,20 % en la partición por orden. El intervalo bootstrap exploratorio del 95 % para la exactitud de prueba fue de 96,40 % a 99,00 %; puede ser optimista si hay dependencia entre cuadros.
Conclusión y límites
Extra Trees fue el mejor de los seis algoritmos evaluados para este dataset y estas configuraciones, tanto en exactitud como en F1 macro en los dos protocolos. La elección surge de los resultados; no se plantea como una premisa del estudio ni demuestra superioridad universal.
No hay metadatos de participantes, sesiones o cámaras. La ausencia de duplicados exactos no demuestra independencia entre registros. Para medir desempeño real con personas nuevas se requieren capturas y particiones por participantes o sesiones, además de comprobar iluminación, orientación, reflejo y relación de aspecto de la cámara.
El sistema clasifica letras estáticas. Concatenarlas como texto y reproducirlas por voz no equivale a traducir la gramática de la lengua de señas ni a reconocer señas dinámicas.
Después de la evaluación se ajustó el algoritmo seleccionado con las 2500 filas y se exportó un modelo compatible. El lector web pasó 400 pruebas de equivalencia con Python sobre vectores sintéticos; estas pruebas comprueban implementación, no precisión con personas. Las aplicaciones publicadas mantienen su versión anterior hasta integrar y validar el modelo nuevo.
Implementación y fuentes
- Aplicación web Señas.
- Repositorio de implementación lsp-estatico — actualmente privado.
- Dataset angular en Kaggle.
- Geurts, Ernst y Wehenkel. Extremely randomized trees, Machine Learning, 2006.
- Zhang y colaboradores. MediaPipe Hands: On-device Real-time Hand Tracking, 2020.
- Scikit-learn: ExtraTreesClassifier y validación cruzada.