
GPT-6 Astra: diseñado para agentes, pero Fable 5.1 conserva la cima
Astra lidera varias pruebas publicadas por OpenAI; Artificial Analysis lo sitúa por detrás de Fable 5.1, pero con 11.9% menos tokens de salida por tarea que GPT-5.6 Sol.
Pregunta
¿GPT-6 Astra es un salto de generación que desplaza a Fable 5.1 como referencia de los modelos frontera, o es ante todo una apuesta de OpenAI por agentes más capaces?
La respuesta, por ahora, tiene dos partes. OpenAI lo diseñó para flujos largos con herramientas, navegador, código y aplicaciones profesionales. Pero la fotografía independiente más reciente de Artificial Analysis no lo sitúa todavía en el primer puesto general ni en el de trabajo agéntico: Fable 5.1 conserva ambos liderazgos.
Evidencia
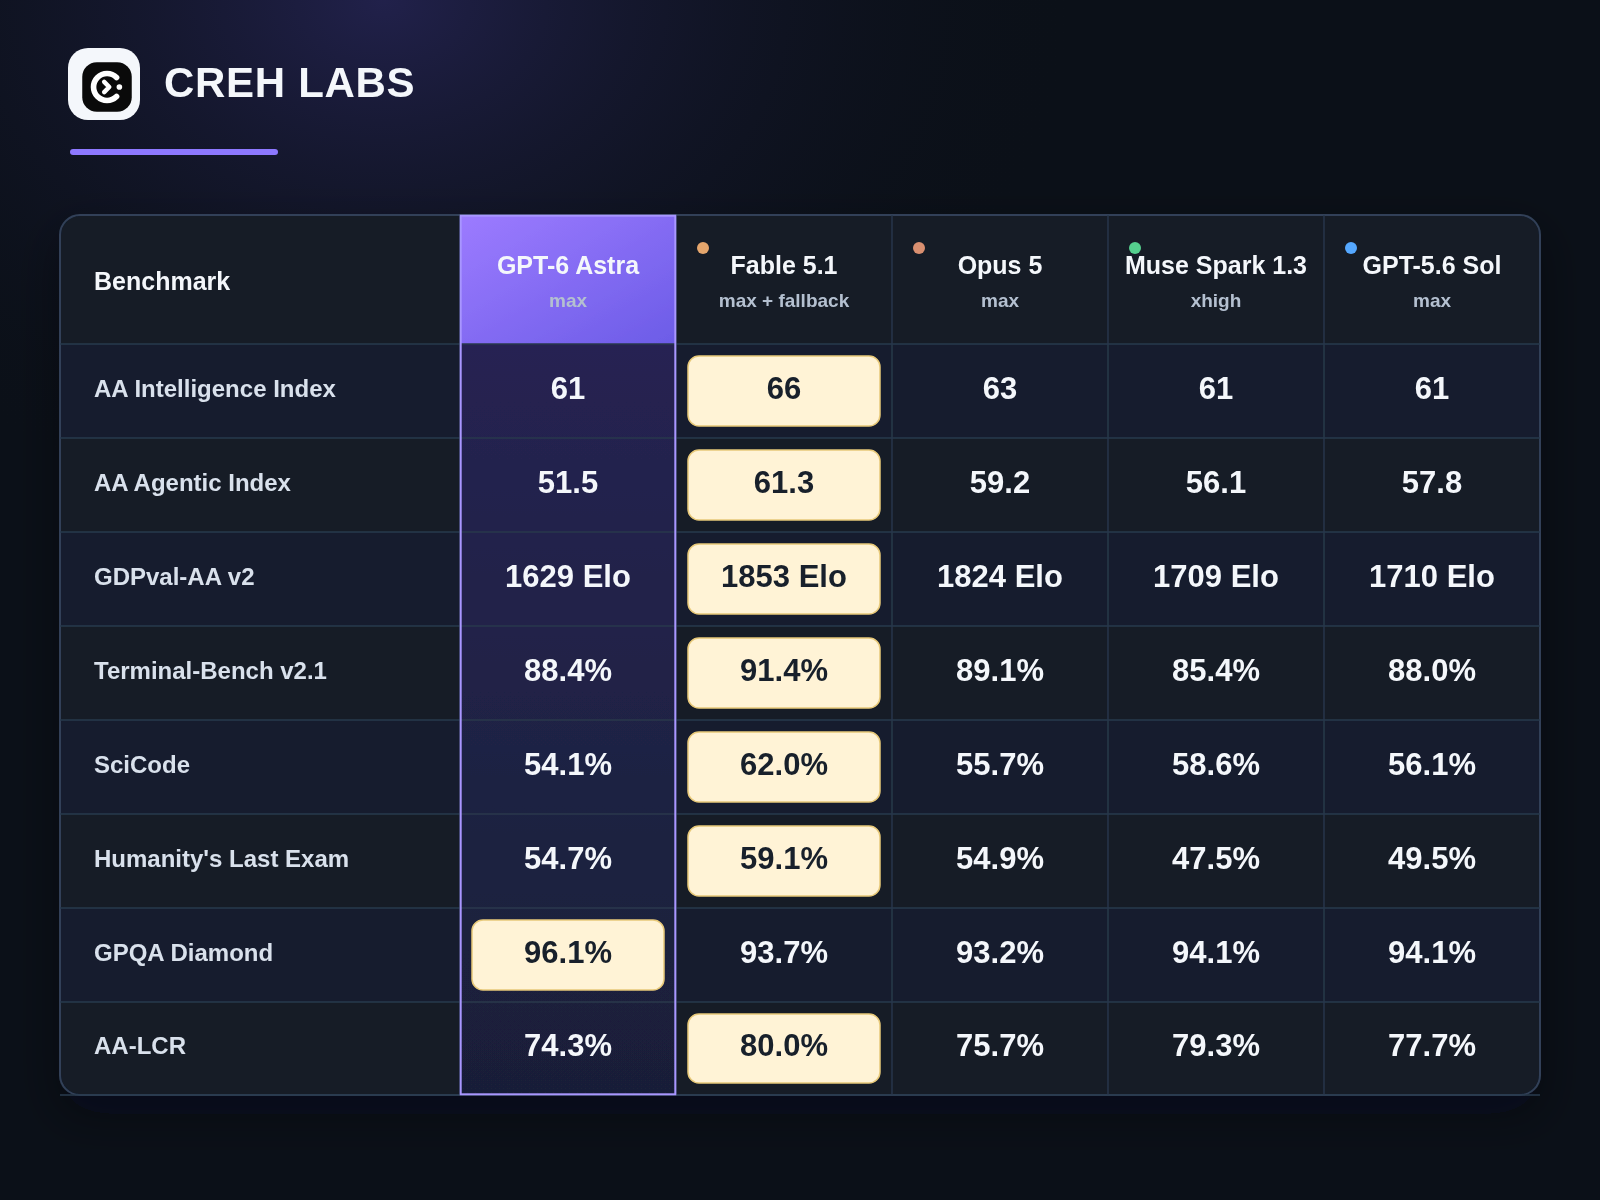
La primera tabla usa datos de Artificial Analysis para configuraciones concretas: GPT-6 Astra max, Fable 5.1 max con fallback por defecto, Opus 5 max, Muse Spark 1.3 xhigh y GPT-5.6 Sol max. La variante xhigh de Muse se eligió porque es la variante frontera con precio y mediciones de proveedor públicas; max continúa sin esos datos.
En el Artificial Analysis Intelligence Index, Astra y GPT-5.6 Sol aparecen ambos como 61 al redondear la puntuación visible. El valor sin redondear de Astra max es 61.22 y el de Sol max, 60.93: una diferencia de 0.29 puntos.
La comparación relevante está delante:
- Fable 5.1 lidera con 66 en inteligencia y 61.3 en el AA Agentic Index.
- Opus 5 registra 63 y 59.2, respectivamente.
- Muse Spark 1.3
xhighobtiene 61 y 56.1. - GPT-5.6 Sol
maxobtiene 61 y 57.8. - GPT-6 Astra
maxobtiene 61 y 51.5.
Por eso sería impreciso afirmar que Astra ya es el líder independiente en agentes. Tiene puntos fuertes muy concretos —96.1% en GPQA Diamond y 88.4% en Terminal-Bench v2.1—, pero Fable 5.1 mantiene ventajas amplias en el índice compuesto, GDPval-AA v2, SciCode, Humanity’s Last Exam y AA-LCR.
Astra está pensado para agentes
La orientación agéntica no es solo una etiqueta comercial. La guía de OpenAI presenta Astra para trabajo multietapa en código, navegador y software profesional; además incorpora llamadas asíncronas a herramientas, steering durante la ejecución, cambio de esfuerzo de razonamiento sin perder caché, computer use, MCP, búsqueda web y shell hospedada.
En la tabla de lanzamiento de OpenAI, Astra lidera los cuatro modelos comparables en varias evaluaciones de uso de herramientas:
| Benchmark publicado por OpenAI | GPT-6 Astra | GPT-5.6 Sol | Fable 5.1 | Opus 5 |
|---|---|---|---|---|
| AutomationBench | 41.4% | 18.1% | 31.4% | 26.9% |
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | 52.3% |
| Terminal-Bench-Science 0.1 | 64.6% | 22.4% | 52.6% | 30.0% |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | 73.7% |
| FrontierMath Tier 4 (v2) | 97.6% | 83.0% | 87.8% | 73.2% |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | 93.7% |
Estos resultados explican la narrativa de Astra: mejor autonomía operativa en tareas donde el modelo debe usar herramientas, iterar y terminar un flujo. La tabla recoge los resultados publicados por OpenAI; la comparación de inteligencia, coste y tokens de la siguiente sección usa la medición independiente de Artificial Analysis.
Coste, velocidad y uso de tokens
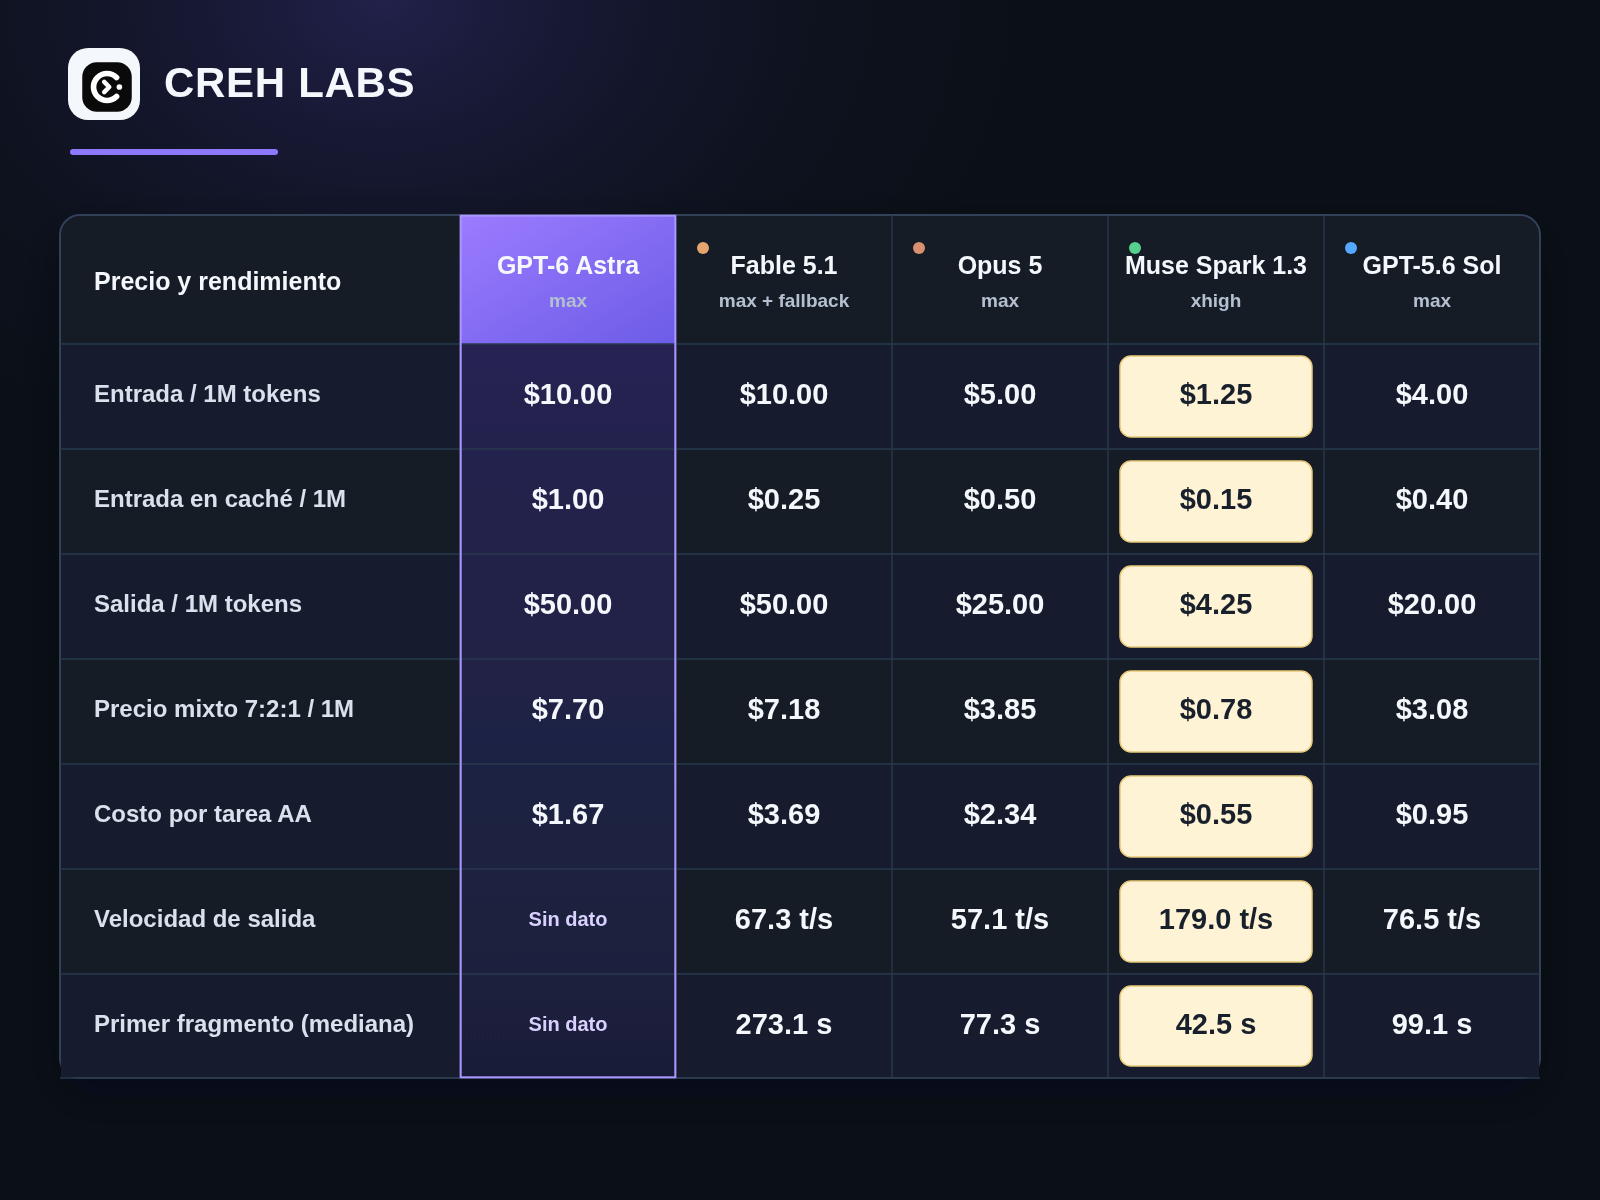
Astra tiene el mismo precio de lista que Fable 5.1: US$10 por millón de tokens de entrada y US$50 de salida. Es 2.5 veces el precio de GPT-5.6 Sol y considerablemente más caro por token que Muse Spark 1.3 xhigh.
Artificial Analysis calcula un coste ponderado por tarea de su índice de US$1.67 para Astra max, frente a US$0.95 para Sol max, US$0.55 para Muse xhigh, US$2.34 para Opus 5 y US$3.69 para Fable 5.1.
En el conjunto ponderado del Artificial Analysis Intelligence Index, Astra genera 14,876 tokens de salida por tarea: 9,965 de razonamiento y 4,911 de respuesta. GPT-5.6 Sol genera 16,879 tokens por tarea: 10,766 de razonamiento y 6,113 de respuesta. Astra utiliza así 2,003 tokens menos por tarea, una reducción de 11.9% frente a Sol, con ambos modelos en una puntuación visible de 61 en el índice.
Lectura
Los datos permiten tres conclusiones directas:
- Para agentes con herramientas, Astra lidera los resultados publicados por OpenAI frente a Sol, Fable 5.1 y Opus 5 en varias pruebas de automatización, terminal y ciencia.
- Para inteligencia general, el indicador independiente mantiene a Fable 5.1 arriba: 66 frente a 61 de Astra; el Agentic Index también favorece a Fable.
- Frente a GPT-5.6 Sol, Astra obtiene el mismo índice visible con 11.9% menos tokens de salida por tarea, aunque su coste ponderado por tarea es US$1.67 frente a US$0.95 de Sol.
Fuentes
- Lanzamiento y tabla de benchmarks de GPT-6 Astra — OpenAI
- Guía de uso y capacidades agénticas de GPT-6 Astra — OpenAI
- GPT-6 Astra
max— Artificial Analysis - Fable 5.1
max— Artificial Analysis - Muse Spark 1.3
xhigh— Artificial Analysis - Opus 5
max— Artificial Analysis - GPT-5.6 Sol
max— Artificial Analysis